
KServe
Kubernetes 上的模型推理平台,支持自动扩缩容、灰度发布与多框架运行时。
Python 经典机器学习库,提供分类、回归、聚类与模型评估等算法,适合数据挖掘与建模入门。
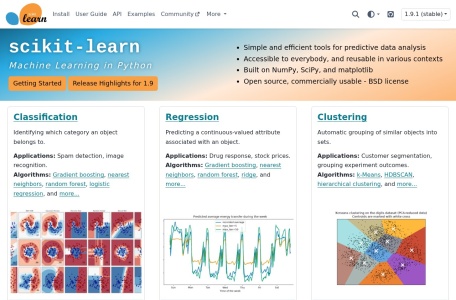
scikit-learn 是 Python 里做机器学习的经典库。分类、回归、聚类、降维、模型选择、数据预处理——这些建模流程里绕不开的环节,它基本都有现成实现。网址是 scikit-learn.org,文档、示例、API 手册都在上面。
什么人该用它?想入门数据挖掘和建模的人,用它最省事。它的 API 设计高度统一,学一个模型等于学会一批:fit 训练、predict 预测、transform 转换,换算法时调用方式几乎不变。你不需要先啃完一堆数学推导才能跑出第一个结果。
常用的监督学习算法都在里面:线性回归、逻辑回归、支持向量机、决策树、随机森林、梯度提升、k 近邻、朴素贝叶斯。无监督这边有 k-means、DBSCAN、层次聚类、PCA、t-SNE。模型评估方面提供交叉验证、网格搜索、多种评分指标,还有 Pipeline 把预处理和模型串成一条流水线,避免数据泄漏。
几个值得知道的事实:
如果你要做的是表格数据的分类预测、特征工程、模型对比,scikit-learn 够用且稳定。教学场景也合适,接口清晰,报错信息友好。
但它不是深度学习框架。神经网络这块它只提供最基础的多层感知机,做图像、文本、序列建模应该转向 PyTorch 或 TensorFlow。另外它默认在单机内存里跑,数据量到了需要分布式计算的规模,就得考虑 Spark MLlib 之类的方案。
装好之后,从官网的 Getting Started 走一遍,重点看 train_test_split、Pipeline 和 GridSearchCV 这三个工具怎么配合。然后挑一个自己熟悉的业务数据集,把「读数据—切分—预处理—训练—评估」整条链路跑通。跑通一次,比读十篇教程管用。
Python 经典机器学习库,提供分类、回归、聚类与模型评估等算法,适合数据挖掘与建模入门。
scikit-learn 的官方网站是 https://scikit-learn.org,可直接在浏览器中打开使用。
