
Supabase
开源的后端服务平台,基于 PostgreSQL 提供数据库、认证与存储,内置 pgvector 支持向量检索。
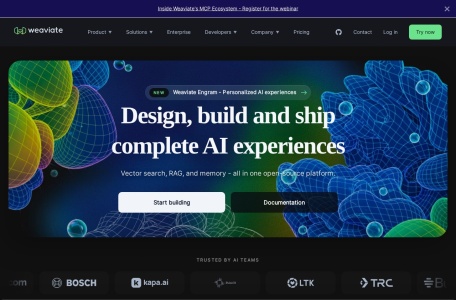
开源向量数据库,原生支持混合检索与多模态数据,可自托管或使用云服务。
Weaviate 是一个开源的向量数据库。你可以把它理解成给 AI 应用准备的"记忆库"——它存储的是文本、图片、音频这些东西经过嵌入模型(embedding model)算出来的向量,然后按语义相似度帮你把相关内容找出来。跟传统数据库按关键词精确匹配不同,你搜"怎么退订会员",它能找到写着"取消订阅流程"的文档,哪怕一个字都不重合。
它适合谁?做 RAG(检索增强生成)的开发者、要给产品加语义搜索的团队、需要处理图文混合数据的项目,以及不想被某家云厂商锁死、希望自己掌控数据的人。Weaviate 两种用法都支持:自己部署(Docker、Kubernetes 都行),或者直接用他们的托管云服务。
很多向量库只管"向量相似度"这一件事,Weaviate 原生把混合检索(hybrid search)做进了内核。也就是说,一次查询里你可以同时用 BM25 关键词打分和向量相似度打分,再按权重融合结果。实际用起来,纯向量检索在专有名词、型号、人名上容易翻车,加上关键词那一路能兜住不少。
多模态也是原生支持的。同一个集合里可以存文本对象、图片对象,甚至引用关系,检索时用文本查图片、用图片查图片都行。它自带向量化模块(vectorizer module),能对接 OpenAI、Cohere、Hugging Face 等一批模型服务,写入数据时自动算向量,省掉自己维护 embedding 管道的麻烦。
另外几个实际会碰到的点:
category = "tech"),再在筛出来的子集里做向量搜索,不是搜完再过滤。Weaviate 用 Go 写的,单二进制部署,启动快、资源占用不算夸张。它的索引结构是 HNSW(一种近似最近邻图索引),这是目前向量检索的主流选择,召回率和速度的平衡比较成熟。数据持久化在磁盘上,重启不丢,也支持水平扩展分片。
查询走的是 GraphQL 和 REST 两套接口,官方客户端覆盖 Python、JavaScript/TypeScript、Java、Go。如果你之前用过别的向量库,迁移成本主要在数据模型设计上——Weaviate 要求你先定义 schema(集合、属性、向量化方式),这个设计好了后面很顺,设计不好改起来有点烦。
开源协议是 BSD-3-Clause,商用没什么限制。社区版功能已经够用,企业版额外提供 RBAC、备份恢复之类的运维能力。
想快速试的话,官方有个免费沙盒云实例,注册就能用,不用先装环境。本地跑就一条 docker compose up,官方仓库里有现成的 compose 文件。文档质量在开源项目里算好的,Quickstart 走一遍大概二十分钟能跑通一个带语义搜索的小 demo。
真要上生产,重点看两件事:向量化模型选哪个(直接影响检索质量,跟数据库本身关系不大),以及数据量上去之后 HNSW 的内存占用——这个参数调不好会比你预期吃内存。
开源向量数据库,原生支持混合检索与多模态数据,可自托管或使用云服务。
开源向量数据库 混合检索 多模态数据支持
RAG 与语义检索 向量相似度搜索 推荐系统与多模态检索
Weaviate 收录于本站的「AI数据库」分类。向量数据库,用于 RAG、语义检索与大规模向量相似度搜索。
Weaviate 的官方网站是 https://weaviate.io,可直接在浏览器中打开使用。
